Kimi K2.5 es el modelo más reciente de modelo de lenguaje visual (VLM) de la familia Kimi. Este modelo multimodal de propósito general destaca en tareas de alta demanda como flujos de trabajo de IA, chat, razonamiento, codificación y matemáticas.
El modelo fue entrenado utilizando el marco de código abierto Megatron‑LM, que proporciona computación acelerada para escalabilidad y optimización de GPU mediante varios tipos de paralelismo (tensor, datos y secuencia) para el entrenamiento de modelos transformadores masivos.
Características del modelo Kimi K2.5
Esta arquitectura se basa en modelos abiertos de vanguardia para lograr eficiencia y capacidad. Está compuesta por 384 expertos con una sola capa densa, lo que permite un tamaño más pequeño de expertos y un enrutamiento especializado para diferentes modalidades. Kimi K2.5 logra una tasa de activación del 3.2% de parámetros por token.
| Kimi K2.5 | |
| Modalidades | Texto, imagen, video |
| Total de parámetros | 1T |
| Parámetros activos | 32.86B |
| Tasa de activación | 3.2% |
| Longitud de contexto de entrada | 262K |
| Información adicional de configuración | |
| # expertos | 384 |
| # expertos compartidos | 1 |
| # expertos por token | 8 |
| # capas | 61 (1 densa, 60 MoE) |
| # cabezales de atención | 64 |
| Tamaño del vocabulario | ~164K |
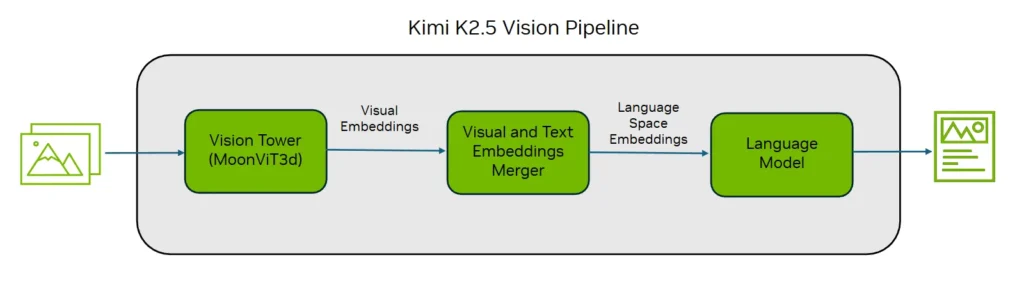
Para la capacidad visual, el extenso vocabulario de entrenamiento de 164K incluye tokens específicos para visión. Kimi desarrolló el MoonViT3d Vision Tower para el componente de procesamiento visual de este modelo, que convierte imágenes y fotogramas de video en embebidos.
Construcción con puntos finales acelerados por GPU de NVIDIA
Puedes comenzar a construir con Kimi K2.5 con acceso gratuito para prototipos en puntos finales acelerados por GPU en build.nvidia.com, como parte del Programa de Desarrolladores de NVIDIA. Puedes usar tus propios datos en la experiencia del navegador. Además, pronto estarán disponibles los microservicios de producción NVIDIA NIM.
También puedes usar el modelo alojado por NVIDIA a través de la API, de forma gratuita con registro en el Programa de Desarrolladores de NVIDIA.
import requests invoke_url = "https://integrate.api.nvidia.com/v1/chat/completions" headers = { "Authorization": "Bearer $NVIDIA_API_KEY", "Accept": "application/json", } payload = { "messages": [ { "role": "user", "content": "" } ], "model": "moonshotai/kimi-k2.5", "chat_template_kwargs": { "thinking": True }, "frequency_penalty": 0, "max_tokens": 16384, "presence_penalty": 0, "stream": True, "temperature": 1, "top_p": 1 } # re-use connections session = requests.Session() response = session.post(invoke_url, headers=headers, json=payload) response.raise_for_status() response_body = response.json() print(response_body)
Para aprovechar la llamada de herramientas, simplemente define un array de herramientas compatibles con OpenAI para añadir al parámetro tools de las completions.
Despliegue con vLLM
Al desplegar modelos con el marco de servicio vLLM, sigue las instrucciones a continuación. Para más información, consulta la receta de vLLM para Kimi K2.5.
$ uv venv $ source .venv/bin/activate $ uv pip install -U vllm --pre --extra-index-url https://wheels.vllm.ai/nightly/cu129 --extra-index-url https://download.pytorch.org/whl/cu129 --index-strategy unsafe-best-match
Ajuste fino con el marco NVIDIA NeMo
Kimi K2.5 puede ser personalizado y ajustado con el marco de código abierto NeMo Framework utilizando la biblioteca NeMo AutoModel para adaptar el modelo a tareas multimodales específicas del dominio, flujos de trabajo agenticos y casos de uso de razonamiento empresarial.
El marco NeMo es un conjunto de bibliotecas abiertas que permite el preentrenamiento y el posentrenamiento escalables de modelos, incluyendo ajuste fino supervisado, métodos eficientes en parámetros y aprendizaje por refuerzo para modelos de todos los tamaños y modalidades.
NeMo AutoModel es una biblioteca de entrenamiento nativa en PyTorch distribuido dentro del marco NeMo que proporciona un entrenamiento de alto rendimiento directamente en el checkpoint de Hugging Face sin necesidad de conversión. Esto ofrece una herramienta ligera y flexible para desarrolladores e investigadores para realizar experimentaciones rápidas en los últimos modelos de frontera.
Prueba el ajuste fino de Kimi K2.5 con la receta de NeMo AutoModel.
Inicio con Kimi K2.5
Desde implementaciones en centros de datos en NVIDIA Blackwell hasta el servicio completamente gestionado de microservicios NVIDIA NIM, NVIDIA ofrece soluciones para la integración de Kimi K2.5. Para comenzar, consulta la página del modelo Kimi K2.5 en Hugging Face, la plataforma Kimi API, y prueba Kimi K2.5 en el playground de build.nvidia.com.