NVIDIA Dynamo ofrece una capa de servicio para los procesos de entrenamiento por refuerzo (RL). Según NVIDIA, sus funciones de enrutamiento, distribución de pesos y recuperación pueden ayudar a generar más muestras aceptadas y completar iteraciones más rápido.
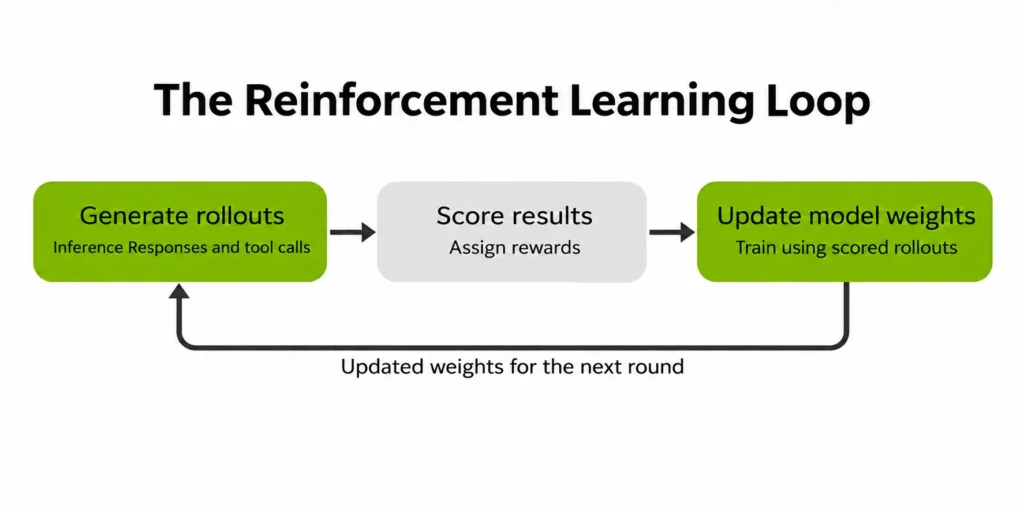
En estos procesos, los trabajadores generan secuencias de respuestas, acciones e interacciones con el entorno. El marco de RL evalúa los resultados, actualiza los pesos del modelo y los devuelve a los trabajadores para la siguiente ronda.
Al aumentar la escala, el trabajo de cómputo redundante, las generaciones lentas, las actualizaciones de pesos y los fallos de trabajadores pueden consumir capacidad de GPU y retrasar el entrenamiento.
Cuellos de botella del entrenamiento por refuerzo
Las cargas de trabajo pueden variar: una generación de razonamiento quizá contenga una respuesta, mientras que un agente de programación puede explorar un repositorio, editar código, usar herramientas y ejecutar pruebas.
Además, el tiempo de finalización depende del proceso más lento cuando se necesita un grupo de muestras. Repartir el mismo número de solicitudes entre GPU no garantiza distribuir el trabajo por igual.
También se puede volver a procesar el mismo contexto en varios intentos. Por otro lado, los trabajadores deben recibir nuevos pesos conforme a los requisitos del algoritmo sobre el muestreo y la antigüedad aceptable.

Arquitectura de Dynamo para RL
Dynamo se sitúa entre la coordinación de las generaciones y los trabajadores de inferencia. El marco de RL envía solicitudes, Dynamo las dirige a capacidad disponible y los motores de inferencia ejecutan el modelo.
Las funciones quedan diferenciadas: el marco de RL gestiona optimización, recompensas, entornos y aceptación de muestras; Dynamo, el enrutamiento y la administración de trabajadores; y el motor de inferencia, la generación y aplicación de pesos.
Además, ModelExpress distribuye pesos y artefactos mediante integraciones compatibles. Las solicitudes de generación y las actualizaciones siguen rutas distintas, bajo el control del marco de RL, que determina cuándo pueden generar los trabajadores y qué resultados son aptos para el entrenamiento.

Esta separación permite mejorar el servicio sin transferir a Dynamo el control del proceso de aprendizaje. Para más información, consulte la referencia de integración de RL.
Enrutamiento, distribución de pesos y recuperación
Enrutamiento consciente de la caché KV
Varios intentos de una tarea pueden compartir la misma instrucción. Enviar las solicitudes a un trabajador que ya tenga ese contexto en caché evita procesarlo de nuevo, aunque concentrarlas allí también puede formar una cola.
Por tanto, el enrutador de Dynamo busca equilibrar la reutilización de la caché KV y la carga de los trabajadores para reducir cómputo redundante y esperas.

Distribución de pesos con ModelExpress
El entrenamiento actualiza repetidamente el modelo, y enviar un punto de control completo a cada trabajador puede llevar tiempo e interrumpir la generación. ModelExpress reutiliza pesos disponibles en el clúster, en lugar de cargarlos desde almacenamiento remoto.
En trabajadores compatibles, los pesos pueden copiarse directamente desde otra GPU mediante NIXL. Además, la transferencia de deltas de pesos envía una representación comprimida de los cambios, que los trabajadores reconstruyen a partir de la versión base correspondiente.


Este mecanismo también puede ayudar a recuperar capacidad: un trabajador de reemplazo puede cargar un punto de control y aplicar deltas posteriores para ponerse al día. El marco de RL coordina las actualizaciones y comprueba la preparación antes de aceptar nuevas muestras.
Recuperación ante fallos
Dynamo detecta la pérdida de trabajadores, dirige nuevas solicitudes a trabajadores aptos y añade reemplazos al enrutamiento cuando están listos. En configuraciones compatibles, también permite migrar solicitudes en curso y realizar un cierre gradual.
El marco de RL gestiona las muestras interrumpidas y verifica que los reemplazos usen los pesos requeridos. La animación muestra cómo, con Dynamo, una sesión compatible puede reanudarse desde el historial guardado en lugar de empezar desde el principio.

Recursos para empezar
NVIDIA presenta Dynamo como una forma de coordinar la generación de secuencias, la distribución de pesos y la recuperación de trabajadores dentro del ciclo de entrenamiento. La documentación de Dynamo para RL ofrece información adicional.