NVIDIA presenta Daviator y una capa de precisión mixta para acelerar cálculos de teoría del funcional de la densidad (DFT) con VASP en GPU. Según las proyecciones publicadas, ambas tecnologías pueden reducir el tiempo de cálculo y el coste para generar datos destinados al entrenamiento de potenciales interatómicos de aprendizaje automático.
Daviator agrupa operaciones de distintos puntos k, que VASP procesa secuencialmente en su implementación OpenACC. El método busca reducir los lanzamientos de kernels y aumentar la utilización de la GPU, especialmente en sistemas pequeños con mallas densas de puntos k.
Procesamiento por lotes y precisión mixta
En las pruebas descritas por NVIDIA, Daviator superó las referencias de CPU y OpenACC en los sistemas evaluados. Para un átomo de hierro, la publicación informa de más del doble de velocidad frente a CPU; en una estructura de GaAs dopada con bismuto y 64 átomos, el tiempo de ejecución se redujo más del 85 %.
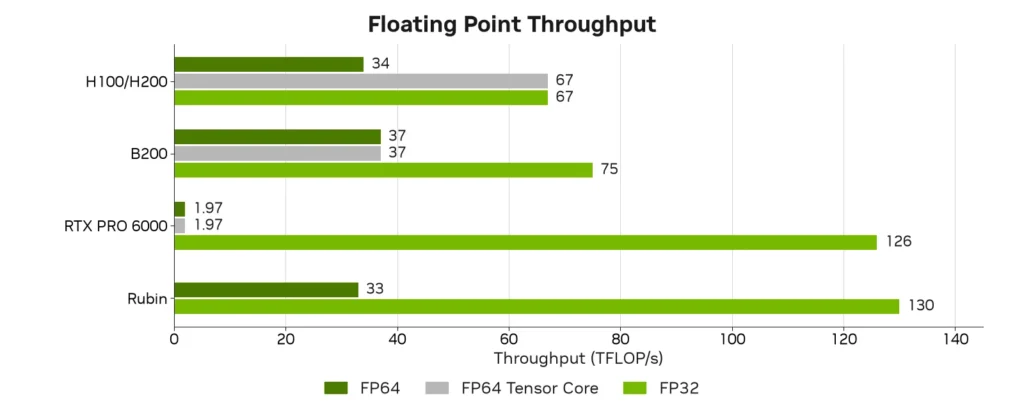
La segunda capacidad combina cálculos FP32 y FP64. La publicación indica que, en una prueba con GaAsBi-64, FP32 permitió acelerar 2 veces el cálculo con un umbral EDIFF de 10-5 eV; una ejecución que pasó de FP32 a FP64 fue 1,5 veces más rápida que FP64 puro con EDIFF de 10-8 eV.
Resultados proyectados y disponibilidad
Para estimar el rendimiento en el conjunto OMat24, NVIDIA extrapoló resultados de 13 entradas representativas. En esa proyección, VASP con Daviator fue hasta 22 veces más rápido que VASP en nodos CPU y hasta 7 veces más rápido que VASP en GPU sin Daviator. El servicio NVIDIA ALCHEMI VASP elevó entre 3 y 5 veces el rendimiento al procesar ocho sistemas pequeños en una GPU.
La estimación de costes sitúa la configuración con RTX PRO 6000, Daviator y FP32 en torno al 25 % del coste de CPU. Para H100, H200 y B200, Daviator redujo el coste estimado a aproximadamente el 35 % del coste de CPU; la precisión mixta aportó hasta 200.000 dólares de ahorro adicional, según el artículo.
Daviator y la opción de precisión mixta estarán disponibles mediante el microservicio NVIDIA ALCHEMI VASP, y se requiere una licencia de usuario de VASP. La ejecución con Daviator está limitada actualmente a un solo nodo; el soporte multinodo y para otras configuraciones se prevé para una etapa posterior.