NVIDIA analiza cómo diseñar atención dispersa para reducir el coste de inferencia con contextos largos en sus GPU. El artículo compara decisiones del indexador, la selección Top-k y la atención central, y ofrece ocho pautas de diseño.
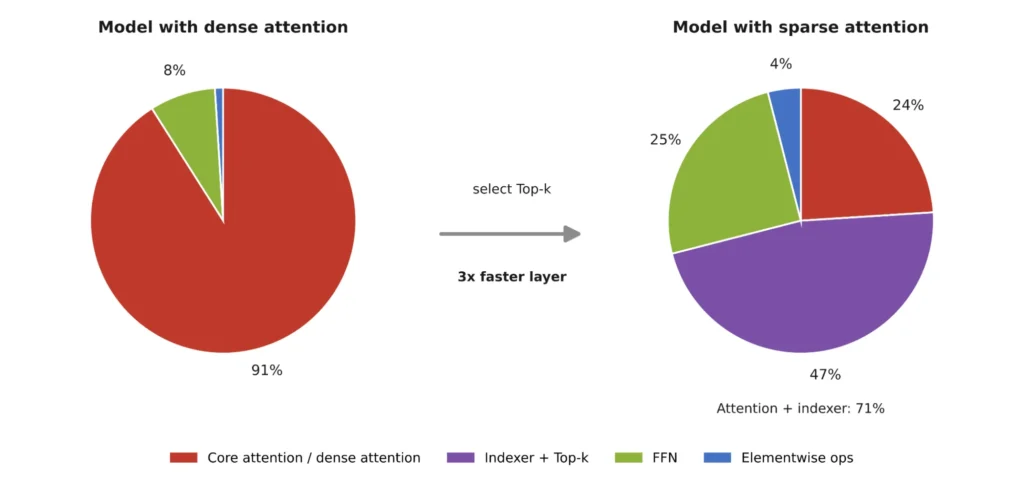
En cargas de trabajo con agentes, documentos extensos y grandes bases de código, los contextos pueden alcanzar cientos de miles de tokens. La atención densa compara cada consulta con todas las claves; a 128.000 tokens, puede ocupar gran parte del tiempo de prellenado de una capa.
Cómo funciona la atención dispersa
La atención dispersa limita las claves que consulta cada token a un subconjunto elegido por relevancia. Esto reduce el cálculo y el tráfico de memoria de la atención central, pero trasladar el coste al indexador no lo elimina: este sigue puntuando todas las claves.
El proceso tiene tres etapas: el indexador puntúa las claves, Top-k conserva las mejor puntuadas y la atención central aplica softmax sobre las claves y valores seleccionados. En el ejemplo de DeepSeek V3.2 a 128.000 tokens, el indexador y Top-k representan el 47 % del tiempo de prellenado por capa.
El análisis se centra en la dispersión integrada durante el entrenamiento, no en métodos aplicados después. NVIDIA evalúa un kernel FP8 y parámetros como las cabezas de consulta y clave, la dimensión de cabeza, la compresión y la decodificación especulativa.
Diseño y coste del indexador
El indexador es un bloque similar a la atención: compara consultas con claves y combina las puntuaciones para producir un logit por clave. La mayoría de los diseños examinados usan una cabeza de clave, entre 32 y 64 cabezas de consulta, dimensión 128 y selección por token o bloques pequeños.
Durante el prellenado, la multiplicación de matrices procesa muchas consultas y suele estar limitada por el cálculo. En decodificación, se puntúan pocas consultas y se lee la caché de claves desde la memoria; por ello, el tráfico de memoria es el principal límite.
El tamaño de grupo, definido como las cabezas de consulta por cabeza de clave, aumenta la intensidad de cálculo. En prellenado, más cabezas elevan el tiempo de ejecución; en decodificación, añadirlas apenas cambia el tiempo mientras se lee una sola vez la caché.
Parámetros para optimizar la decodificación
La decodificación especulativa permite puntuar varios tokens de consulta contra la misma caché en un paso. Mientras quepan en una pasada del kernel, el coste aumenta poco; al superar la capacidad práctica de la tesela, el tiempo sube al necesitarse más bloques de trabajo.
NVIDIA recomienda mantener el producto entre el tamaño del grupo y los tokens procesados por paso dentro de una tesela: unas 200 filas, o 256 con una epíloga FP16. También plantea usar FP16 en la epíloga y, si la escala de QK mantiene las salidas dentro del rango, en la acumulación.
Aumentar las cabezas de clave implica más lecturas de la caché y más logits. En las mediciones, pasar de una a ocho cabezas multiplicó por 7,6 el tiempo de decodificación; por ello, el artículo recomienda una cabeza de clave y reducir las puntuaciones entre cabezas de consulta.
Dimensión y compresión de las claves
Una dimensión de cabeza mayor aumenta la intensidad de cálculo del prellenado, pero también los datos que debe leer la decodificación. Las mediciones muestran que pasar de dimensión 64 a 128 aumenta el tiempo de prellenado entre 1,1 y 1,2 veces; en decodificación, el tiempo crece aproximadamente con la dimensión.
La recomendación es usar dimensión 128 o 256; la mayoría de los diseños se sitúan en 128. Reducir la dimensión puede recortar los bytes leídos durante la decodificación, aunque una dimensión de 64 deja capacidad de cálculo sin aprovechar durante el prellenado.
La compresión del índice reduce proporcionalmente el trabajo en ambas fases. El artículo también señala la indexación jerárquica y el uso compartido de índices entre capas como formas de reducir las claves puntuadas, sin sustituir los ajustes de intensidad de cálculo.
Top-k y selección por bloques
El coste de Top-k depende más del número de claves puntuadas que de cuántas se conservan. NVIDIA describe dos opciones para reducirlo: reutilizar en decodificación la selección del paso anterior como estimación y fusionar Top-k con el indexador para evitar escribir y volver a leer todos los logits.
La selección por bloques permite recuperar claves y valores contiguos en grupo, mientras que la selección por token requiere búsquedas y recuperaciones individuales. Según el artículo, los bloques pequeños elevan el tiempo porque añaden cargas de consulta, resultados parciales y operaciones de combinación.
Por tanto, NVIDIA recomienda bloques grandes y un tamaño de grupo amplio en la atención central, para que varias cabezas de consulta compartan cada cabeza de clave. La selección por token también puede utilizarse, aunque no ofrece la misma recuperación de datos en bloque.
Ocho pautas de diseño
El artículo resume sus recomendaciones para GPU NVIDIA: limitar el tamaño del grupo y los tokens especulativos a la capacidad de una tesela; usar una epíloga FP16 y, bajo las condiciones indicadas, acumulación FP16; y mantener una cabeza de clave con reducción entre cabezas.
También propone dimensiones de cabeza de 128 o 256; reducir las claves puntuadas mediante compresión, indexación jerárquica o índices compartidos; e incluir Top-k en el presupuesto del indexador, fusionándolo y reutilizando resultados anteriores durante la decodificación.
Finalmente, recomienda selección por bloques grandes y un grupo amplio en la atención central. El objetivo es equilibrar el coste del indexador, Top-k y la atención central, ya que la atención dispersa reduce el trabajo de esta última, pero el indexador sigue recorriendo el contexto.